Classifier-free guidance
CFG 到底做了什么
CFG 是扩散模型和流模型采样时几乎默认开启的技巧,公认能让输出更贴合条件,生成质量通常也更高。但 CFG 对输出分布究竟做了什么,一直没有共识。
Classifier-free Guidance(CFG)[1]的做法很简单:采样的每一步让模型算两次,一次带条件、一次不带,再把两个结果按一个系数 γ 组合起来。γ 越大,输出越贴合条件,生成质量通常也越高——这一点在实践中相当稳定,所以几乎没有人把 γ 设回 1。
至于「为什么会这样」,最早那批工作给出的解释是:CFG 相当于降低采样温度,让分布变得更尖锐、更集中在高概率的地方。这个说法流传最广,也写进了很多教程。
但这个说法很可能是错的。过去两年有多篇论文各自否定了其他论文对 CFG 的理解,而且分歧不在措辞,在于 CFG 到底把输出分布变成了什么样子。
而在所有分歧之上,还有一个大家都默认、却很少明确指出的矛盾:
如果 CFG 把分布推离了真实数据,为什么 γ 调到 5 的结果,比 γ=1 更好?
这篇文章分三层回答。
第一层,CFG 想做什么(第二节)。在一个理想模型下——假设 CFG 只作用一次,而且采样结果就是这一次算出来的分布——把 γ 调大,同一个条件下的输出会怎么变:哪些 mode 变得更常见、每个 mode 的中心往哪移、同一个 mode 内的样本还剩多少差异。这三件事都能推出确切的形式。
第二层,实际和理想有差距(第三、四节)。真实采样得到的分布并不是理想模型算出来的那个,有两个原因:CFG 的 tilt 和加噪的顺序反了,以及 CFG 不是作用一次而是每一步作用一次。前一个原因和步数无关,也和采样器是不是确定性的无关——步数取到无穷多也消不掉。
第三层,为什么生成质量仍然变好(第五、六节)。因为 CFG 修的不是分布,是模型本身的误差。
第一节先把公式和记号交代清楚。行文以 rectified flow / flow matching 为主,DDPM 和 DDIM 只在需要对照时出现。
01CFG 的公式,和背后那个分布
先交代采样过程。Rectified flow 的采样从纯噪声出发,沿一条轨迹走到干净数据:每一步,模型根据当前的 x 和噪声水平 t,输出一个速度——往哪个方向走、走多少。把这些步积分到 t=0,就得到一个样本。
不加 CFG 时,模型每步只运行一次,输入条件得到 v_c,沿 v_c 走一步。
CFG 改的就是这一步:每步运行两次——一次带条件得到 v_c,一次去掉条件得到 v_u——然后用两者的线性组合去走:
这一步实际走的 = v_u + γ · (v_c − v_u)γ 就是各家 pipeline 里的 guidance_scale。γ=1 时右边化简成 v_c,回到不加 CFG 的情况;γ>1 则是沿着条件带来的那一点差别再多走一段。
DDPM 和 DDIM 里模型输出的不是速度,而是噪声 ε,但 CFG 的写法完全相同,只需把上式的 v 换成 ε。下面的结论两种参数化都成立,理由在折叠块里。
这一步在分布层面等于什么
模型输出的速度和分布的 score(∇log p)之间是一一对应的——知道速度就能算出 score,反过来也一样。所以把两个速度线性组合,等价于把两个 score 线性组合:
(1−γ) · ∇log p(x) + γ · ∇log p(x|c)而这一串恰好是 log[ p(x|c)^γ · p(x)^(1−γ) ] 的梯度。换句话说,CFG 每一步沿着的,是这个分布的 score。整理后得到:
p_γ(x|c) ∝ p(x|c) · r(x)^(γ−1) 其中 r(x) = p(x|c) / p(x)所以 γ 在分布层面做的事是:把 p(x|c) 按 r 重新加权一遍。r 大的地方被放大,r 小的地方被压低,γ 决定力度。
「把一个分布乘上一个权重函数再归一化」这个操作有个现成的名字,叫 tilt。下文一律用 tilt 指代 CFG 在分布层面做的这件事——CFG 就是对 p(x|c) 做了一次以 r^(γ−1) 为权重的 tilt。
后面会反复用到三个词,先给出定义:
| 词 | 指什么 |
|---|---|
| 密度 | 某个具体输出出现的相对可能性。p(x|c) 在哪里高,采样就更容易落到哪里。 |
| 占比 | 采样很多次之后,落在某一类结果里的样本比例。占比是密度在那一类结果上的积分,也是实验里真正能数出来的量。 |
| r | 同一个输出在 p(x|c) 下的密度,除以在 p(x) 下的密度。 |
r 是这篇文章里最重要的一个量,需要单独说明。r 衡量的是:这个输出在多大程度上是因为条件才出现的。
r很大 —— 这种结果基本只有给了条件才会出现r接近 1 —— 不给条件也一样会出现,所以这样的结果和条件关系不大
换个角度:r 正比于「看到这个输出、条件是 c 的概率」,也就是模型内部隐含的那个分类器。CFG 没有真的训练分类器,但始终在依据这个比值决定方向。
推导:两步贝叶斯
classifier guidance 把 classifier 项乘上一个系数 γ:score 变成∇log p(x) + γ∇log p(c|x)。给对数梯度乘 γ,等于给那一项取 γ 次幂,所以这一串是 p(x)·p(c|x)^γ 的 score。
再用一次贝叶斯消掉分类器:∇log p(c|x) = ∇log p(x|c) − ∇log p(x),代回去得到(1−γ)∇log p(x) + γ∇log p(x|c),正是 CFG 的线性组合。对应的分布p(x|c)^γ p(x)^(1−γ) 整理后即为上式。
flow matching 下的换算:∇log p_t(x) = −[x + (1−t)v(x,t)]/t,于是∇log r = −((1−t)/t)(v_c − v_u)。系数恒正且不依赖 x,所以下文所有关于符号、零点、单调性的结论,在 v 参数化和 ε 参数化下完全一致。
全文的符号
| 符号 | 含义 | 典型值 |
|---|---|---|
| x | 数据点(模型内部的 latent) | — |
| c | 条件 | — |
| t | 噪声水平 | 0 = 干净,1 = 纯噪声 |
| γ | guidance scale | 1 = 不加 CFG;文生图常用 5–9;SDS 用 100 |
| v_c, v_u | conditional / unconditional 分支的输出 | — |
| Δ | v_c − v_u,CFG 的方向 | — |
| r | conditional 密度 / unconditional 密度 | — |
| x* | Δ = 0 的点,两个分支给出相同预测的地方 | — |
02单步理想模型:CFG 想做什么
这一节讨论一个理想模型,前提是两件事:
- CFG 只作用一次,作用在干净数据的分布上
- 采样结果就是这一次作用算出来的
p_γ
真实采样中这两条都不成立,后面两节分别处理。但先把理想模型讲透是值得的:下面三个结论在真实采样里方向依然成立,只是数值并不一致——没有这个理想模型,就不知道该去测什么。
在这个理想模型下,把 γ 调大会发生三件事:
| 发生了什么 | 形式 | |
|---|---|---|
| 效应一:mode 之间重新分配 | 有的 mode 被放大,有的被压低,而且差距是指数级的 | 占比之比 ∝ (r_A/r_B)^(γ−1) |
| 效应二:中心挪开然后停下 | 中心离开原位,但会停在一个固定的点上 | 停在一个固定的点 x* |
| 效应三:每个 mode 变窄 | 同一个 mode 内部的样本越来越像 | 方差 ∝ 1/(γ−1) |
1 = 不加 CFG。文生图常用 5–9。
unconditional 分布的宽度。单个 mode 固定是 0.5。
效应一mode 之间按 r 重新分配
先看这条结论为什么成立。p_γ 是 p(x|c) 乘上 r^(γ−1)。单个 mode 很窄,r 在这个 mode 内部近似是个常数 r_j,所以这一整个 mode 的占比就是原来的占比乘上 r_j^(γ−1):
占比_j ≈ w_j · r_j^(γ−1) w_j 是这个 mode 在 p(x|c) 下的占比 占比_A / 占比_B = (w_A / w_B) · (r_A / r_B)^(γ−1)γ 在指数上,所以差距是指数级拉开的。但关键不在「指数」,在于被拉开的是 r 的比,不是密度的比。图里 mode A 起始占比 0.6、B 只有 0.4,但 A 坐落在 unconditional 分布(虚线)的正中央,B 在尾巴上,所以 r_B > r_A。把 γ 增大到 4,更高的那个峰降下去,更矮的那个升上来,翻转发生在 γ≈1.8。
CFG 挑的不是「最可能」的 mode,是「最只能由条件解释」的 mode。
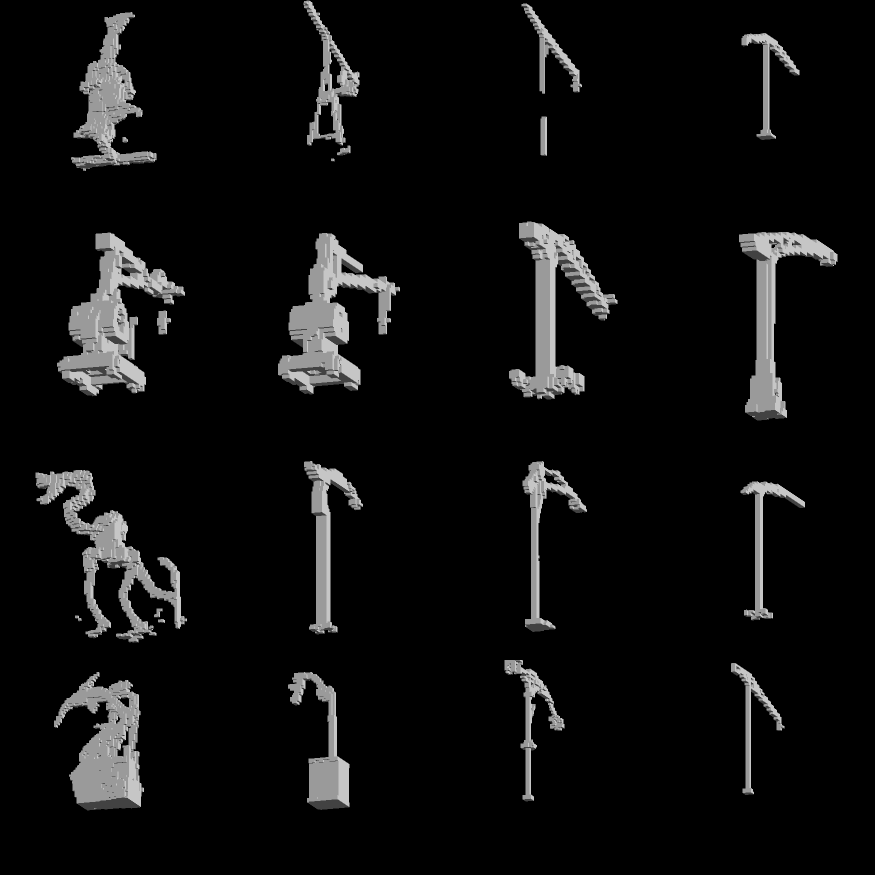
a crane,行是种子,列是 γ,同一行只有 γ 在变。 γ=1 那一列是有腿、有躯干的生物形态;到 γ=6 全都成了塔吊。 英文 crane 同时指起重机和鹤,不加 CFG 时模型两个都做;γ 增大后,鸟这一类就消失了。 种子并非人工挑选:16 个种子在 γ=1 时按判别轴打分,取最偏「生物」的四个。
a crane,γ=1 时塔吊只占 10%,是少数的那一类;γ 增大后升到 30%。如果 CFG 是低温采样,少数 mode 应该被压向零、多数(鸟)越来越多——实测正好相反。塔吊被放大,是因为 unconditional 分支本来就常生成鸟和其他生物形态,塔吊是「只有给了条件才更可能出现」的那一类,r 更大。下面那条线是对照:把条件改成
a crane, the long-legged wading bird,同一个塔吊 mode 从 0.047 降到 0.008。方向反过来,说明被放大的不是「塔吊」这个 mode 本身,而是条件决定的 r。一个流行说法为什么不成立:CFG 不是低温采样
低温采样做的是 p(x|c)^γ,只有分子,mode 占比之比是 (w_A/w_B)^γ——只会让本来就大的 mode 更大。CFG 多了一个分母 p(x)^(1−γ),专门惩罚「不给条件也常见」。在图里这个例子上:
低温采样:A 持续占优 (0.6/0.4)^γ 单调增大 CFG :B 反超 γ≈1.8 之后反转同一个分布、同一个 γ,两种操作把样本推向相反的 mode。所以「CFG 约等于降低温度」不只是不精确——在选哪个 mode 这件事上,方向是反的。
效应二每个 mode 的中心挪开,然后停下
在单个 mode 内部,中心会离开原位,朝着远离 unconditional 分布的方向移动,但不会一直走。把 CFG 公式括号里的那个差值记为:
Δ = v_c − v_u 整个 CFG 就是「在 v_u 的基础上,沿 Δ 多走 γ 倍」x* 就是 Δ = 0 的地方——两个分支给出相同预测的那个点。
Δ 正比于 ∇log r(换算在折叠块里),而 x* 是 r 的极大点,梯度为零,所以 Δ 在那里也等于零,CFG 恰好消失,而且样本会被吸向这个点。图里第二个小图是 mode B 的中心随 γ 的变化:起初上升很快,随后迅速趋平,停在 x* 上,γ 从 5 增大到 12 几乎不再移动。
注意这里有一件反直觉的事:γ 越大,样本越接近 CFG 自己消失的那个点。第四节会看到,这个模型上并不存在这样一个点。
效应三每个 mode 变窄,速度是 1/(γ−1)
同一个 mode 内部的方差按 1/(γ−1) 下降。标准差则按 1/√(γ−1) 收缩,比中心停下来慢——这意味着 γ 大到一定程度之后,采到的样本不再改变,只是彼此越来越像。
推导:为什么是 1/(γ−1)
写 β = γ−1。目标是 p(x|c)·r^β,取对数后在 x* 处展开:log r 的一阶项为零(极值点),二阶项带上 β 权重,于是 β 主导了曲率。配方之后得到一个高斯,协方差是 H⁻¹/β,其中 H 是 −∇²log r(x*)。所以方差正比于 1/(γ−1),均值以同样的速度趋近 x*。
在一维高斯的例子上数值核对过:γ=100 时精确解方差 0.01329,这个近似给 0.01347。
1/(γ−1) 慢:γ−1 变化 96 倍,方差只降到 30–61%,第四节会说为什么。拖第二个滑块 σu,把 unconditional 的宽度调到和单个 mode 一样(0.5),收窄就消失了。也就是说:
一个 mode 会不会变窄,取决于这个 mode 自己有多窄和 unconditional 分布有多宽——两者差得越多,收窄越强。γ 只是个放大器:两者一样宽时,γ 再大也只是把整个 mode 挪走。
这个前提在真实模型上并不总是成立:有一半的方向不满足。把一个条件下的 latent 分布做主成分分解,取前十二个主方向,逐个方向比较 conditional 和 unconditional 的宽度:
| 方向 | γ 从 1 增大到 25,宽度变成原来的 |
|---|---|
| 六个方向,conditional 本来更窄 | 0.21–0.45(收窄,符合效应三) |
| 六个方向,conditional 本来更宽 | 扩张,最宽的那个方向在 γ=3 处达到 1.95 倍 |
而且扩张的峰值落在 γ=2–5,正是实际在用的区间。所以:
CFG 不是各向同性的收缩。CFG 一边把 conditional 本来就更窄的方向继续压缩,一边把 conditional 本来更宽的方向扩张。用一个标量方差去衡量,两者部分相抵,只看得到一个净收窄,看不出两类方向的变化方向相反。
γ 推到极限,样本会集中到哪
r^(γ−1) 是个指数放大器:γ 推到极限,所有概率都集中到 r 最大的那个点,而不是 p(x|c) 最大的那个点。
极限处得到的是「最能和 unconditional 区分开的 c」,不是「最典型的 c」——γ 不大时两者差别不明显,γ 增大后差别迅速拉开。
03理想和实际的差距从哪来
实际采样得到的分布,和上一节理想模型算出来的 p_γ 并不一致。原因出在一个很具体的地方:CFG 的 tilt 和加噪这两件事的先后顺序反了。
理想模型里,tilt 作用在干净数据的分布上,得到 p_γ。要让采样真的结束在 p_γ 上,采样器每一步看到的就必须是 p_γ 加噪之后的样子——先 tilt,再加噪。
但模型学的是 p_t(x|c) 和 p_t(x):干净数据直接加噪得到的两个分布,中间没有经过 tilt。CFG 的 tilt 只能加在这两个已经加过噪的分布之上——先加噪,再 tilt。
需要的: 干净数据 ──tilt──▶ p_γ ──加噪──▶ 采样器看到的 CFG 给的:干净数据 ──加噪──▶ 两个分布 ──tilt──▶ 采样器看到的这两个操作不可交换。只有在完全没加噪时,两条路给出的才是同一个分布。p_γ 是按干净数据定义的,所以 p_γ 本身没算错;但采样沿着的是另一条路,最后落在别处。这不是精度问题——就算步数取到无穷多、模型学得完全准、用确定性采样器,走的仍然是另一条路,结果照样不是 p_γ。
0 = 干净数据,3 ≈ 纯噪声。采样从右往左走。
γ=1 时两条路完全重合,没有分歧可言。
γμ₁+(1−γ)μ₀:噪声越大,CFG 给的那条路越靠近这个朴素外插值,而需要的那条路的均值根本不动。例子:p₀(·|c)=N(1,1),p₀=N(0,4)。04多步采样下,三个效应的变化
理想模型里 CFG 只作用一次。实际采样里 CFG 在几十步中每一步都作用一次,而且每一步作用在不同的噪声水平上。同一个 tilt 放在不同的噪声水平上,效果并不一样。
预测:每个效应有自己的噪声区间
决定三个效应各自强弱的是同一个量:conditional 的单个 mode 有多窄,和 unconditional 分布有多宽,两者差多少。噪声会同时抹宽这两个分布,所以这个差距随噪声水平变化——于是每个效应有自己的活跃区间。
| 高噪声 采样刚开始 | 中噪声 | 低噪声 采样快结束 | |
|---|---|---|---|
| 效应一:mode 之间重新分配 | mode 还混在一起,无从加强或削弱 | 起作用 | 已经确定,无法改变 |
| 效应二:中心挪开然后停下 | 持续外移 | 位移开始收敛 | 已经停在 x* 上 |
| 效应三:每个 mode 变窄 | 几乎没有——两边的宽度被噪声抹平了 | 开始出现 | 最强 |
拖动可以看到两个峰如何合并、中间的谷如何被填平。
γ 放大三条曲线,但不改变曲线的位置。
mode 间距决定中间那一段落在哪里。
exp(−谷深),借自 Kramers 逃逸率,是个近似。实测:三条预测只有一条成立
以下结果都在我们自己的 3D rectified-flow 模型上测得。开 CFG 和不开 CFG 两组使用同一批种子、同一份初始噪声,逐步比较两组对干净样本的估计。t′ 是模型实际收到的噪声水平,1 是纯噪声,采样从右往左走,共 45 步。
| 效应 | 预测 | 实测 |
|---|---|---|
| 效应一 | 中段最强 | 错。在高噪声段就已完成 |
| 效应二 | 高噪声最强 | 对。位移在最高噪声处最大,之后单调衰减到七分之一 |
| 效应三 | 低噪声最强 | 需要修正。高噪声处 CFG 先使分布扩张,净收窄要到低噪声才出现;低噪声段只有效应三在起作用 |
效应一|mode 之间重新分配:在高噪声段已经完成
每一步把两组样本投影到一条 mode 轴上,读出落在每个 mode 上的质量。拟合时允许整团样本沿这条轴平移,所以读到的是真正从一个 mode 转移到另一个 mode 的质量,不是平移造成的假象。
噪声水平 t′ | 0.992 第 1 步 | 0.881 | 0.832 | 0.706 |
|---|---|---|---|---|
| 两组权重差距完成的比例 | 61% | 87% | 98% | 100% |
第二行是到这个噪声水平为止,两组 mode 权重之差相对终点的总变化量已经完成了多少。第一步就完成 61%,到 t′=0.832 完成 98%,t′=0.71 以下不再变化。预测说中段最强,实测在最高噪声处就基本结束。
这和预测直接冲突:t′=0.99 时两个 mode 已经重叠在一起,怎么还能在两者之间转移质量?因为加噪不改变混合权重。前向过程把每个成分压向原点、彼此重叠,但每个成分前面的权重在任何噪声水平上都原封不动。高噪声抹去的是两个成分的位置信息——所以单个样本在那里无法归类——而不是 CFG 作用的那个权重。
把两组分开看,还有一件事:开 CFG 那一组的 mode 权重在 t′=0.96 就不再变化,剩下 39 步只改变了 0.002,而不开 CFG 那一组持续变化到 t′≈0.71 才停。所以两组之间的差距继续拉大,是不开 CFG 那一组在变化,不是 CFG 还在起作用。
效应二|中心挪开然后停下:前半句成立,后半句不成立
噪声水平 t′ | 最高 | 中段 | 终点 |
|---|---|---|---|
| 两组中心之间的距离 | 2.60 | 0.46 | 0.39 |
距离的单位是不开 CFG 那一组在终点的散开程度。中心位移在最高噪声处最大,之后单调衰减到七分之一——预测说的「高噪声最强」成立,而且是三条预测里唯一成立的一条。
但理想模型还说了后半句:中心会停在 x*,也就是两个分支给出相同预测的那个点。实测中心并不停下。把中心位移对 γ 拟合一条会饱和的曲线,实测的点越过了那条曲线预测的极限值——这个模型上不存在 x*,样本停下来不是因为走到了那个点,是因为 45 步走完了。
效应三|每个 mode 变窄:先扩张,很晚才收窄
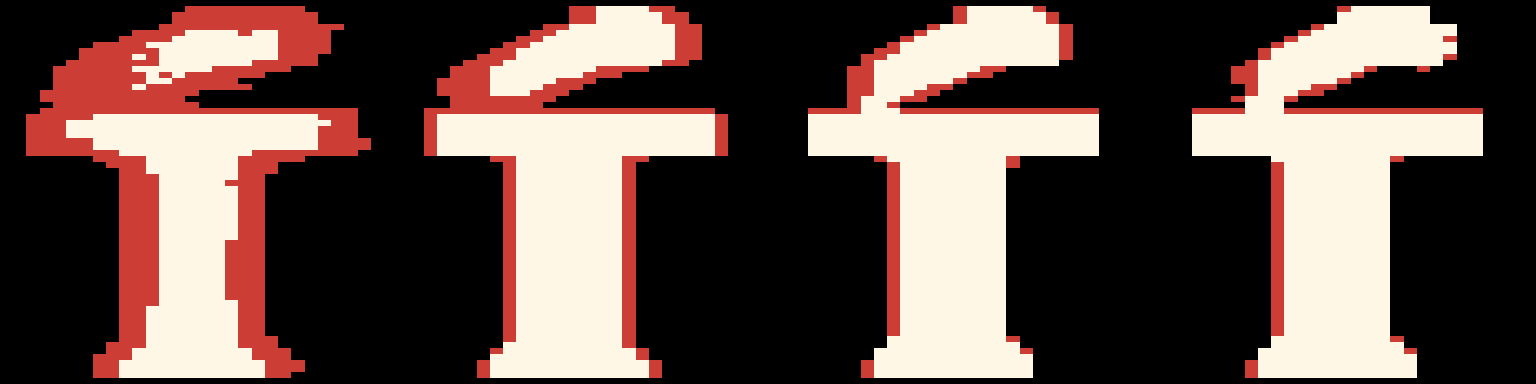
x₀ = x_t − t·v 在种子之间的方差,以不开 CFG 那组在终点的值为 1。(两组共用初始噪声,所以量 x_t 本身在第一步恒等。)在 t′=0.977 处开 CFG 那组是 1.9 倍——CFG 在这里不是收窄,是扩张。扩张的原因是:高噪声处模型还没看到信号,同一个条件下每个种子的 x₀ 估计几乎是同一个,不加 CFG 那组本来就没有多样性;而 CFG 把种子之间那一点微小差异乘上了 γ−1,在这一段又几乎不衰减,于是比值被拉大。预测说低噪声最强。实测的方向在高噪声段是反的:CFG 在那里不是收窄,而是使分布扩张到 1.9 倍(上图,原因见图注)。扩张随噪声下降而衰减,净收窄要到 t′≈0.65 之后才出现,而且最终只剩那次扩张的 8%(另两个输入上 28% 和 16%)。
这解释了第二节的 1/(γ−1) 为什么和实测相差这么多:γ−1 变化 96 倍,方差只降到 30–61% 就停住——大部分收缩只是在抵消此前的扩张。
不过预测里还有一半是对的:低噪声段确实只有效应三在起作用——但理由不是收窄在那里最强,而是另外两个已经停了。
第二节的结论还剩下什么
方向性的结论均成立,而具体数值与理想模型的公式不符。
| 效应 | 方向:成立 | 数值:不成立 |
|---|---|---|
| 效应一 | 按 r 而不是按密度选 mode。a crane 下只占 10% 的少数 mode 被放大了三倍,低温采样只会把少数压向零 | 理想模型说两个 mode 的占比之比随 γ 指数增长。γ 较小时确实如此,γ 较大时几乎不再变化 |
| 效应二 | 中心朝远离 unconditional 分布的方向移动 | 理想模型说中心会停在 x*。实际不停,而且越过了饱和曲线预测的极限值——这个模型上没有 x* |
| 效应三 | 方差随 γ 下降 | 理想模型说方差正比于 1/(γ−1)。实际下降慢得多,而且有下限:γ−1 变化 96 倍,方差只降到 30–61% |
这些关于方向的结论不只是「看起来还对」,其中几条已被严格证明:Wu 等人[2]证明 CFG 会降低输出分布的微分熵、提高分类置信度,DDPM 和 DDIM 都成立;Li 和 Jiao[3]在一般分布下证明 CFG 会降低分类概率倒数的期望。关于方向的结论最可靠,而这些结论恰好也是最有用的。
05那为什么生成质量会变好
到这里出现一个真正的问题。三个效应——mode 之间重新分配、中心挪开、mode 变窄——没有一个能解释生成质量为什么会变好。尤其是第二节最后那个结论:γ 推到极限时,样本集中到的是「最能和 unconditional 区分开」的点,而不是最典型的点——照理应该更不像真实数据。
缺的是一个前提:
到这里为止的所有分析都默认模型是对的。一旦承认模型本身是偏的,这个矛盾就没有了。
一个很简单的推论
假设 γ=1 时模型给出的就是真实的条件分布。那么任何 γ>1 都只会让结果离真实分布更远,质量指标应该从 γ=1 起单调变差。
但实践中没有人把 γ 设成 1。最优的 γ 总是大于 1,这是普遍的使用经验,文献里的 FID-γ 曲线也是这个形状。于是:
存在 γ > 1 优于 γ = 1 ⟹ γ = 1 时模型本来就是偏的推理很简单,结论并不小:CFG 修的不是分布,是模型的误差。
这是什么误差,r 为什么能修
Karras 等人[4]给了一个具体的说法:score matching 训练会让模型把概率放到真实数据根本不会出现的地方,产生 outlier,而 CFG 会去掉这些 outlier。
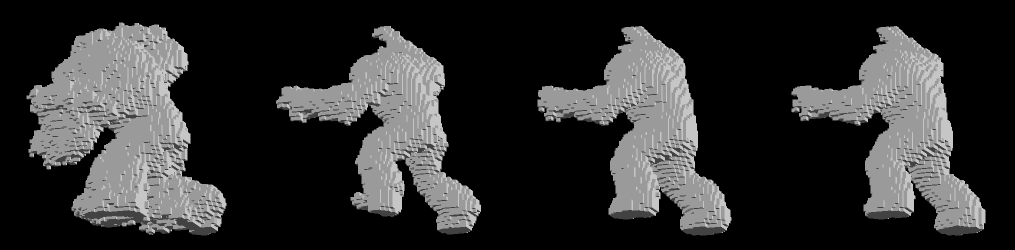
为什么 score matching 会把概率放到没有数据的地方
训练目标本质上在最小化 KL(p_data ‖ p_model)。两种错误的代价完全不对称:
- 数据存在、模型给出接近零的密度 ——
log项发散,惩罚无穷大 - 数据不存在、模型给出正的密度 —— 前面乘的
p_data ≈ 0,几乎没有惩罚
漏掉真实数据的代价极大,在没有数据的地方多放密度几乎没有代价。容量无限时两者都能做到;容量有限时二者冲突,模型只能偏向把密度铺得更开。
结果是学出来的密度比真实的更平、更散,本该是零的空隙被填上。Karras 等人的二维例子展示的就是这一点:真实分布是树状结构,学到的密度明显更宽,采样会落到枝杈之间的空白处。
注意这是估计误差,不是扩散模型的固有性质——数据和容量都够时,score matching 能收敛到真实 score。第六节「CFG 的必要强度反映模型的误差」这一条就建立在这一点上。
关键在于这种误差的性质:误差来自模型学得不够准,和给不给条件无关——conditional 和 unconditional 两个分支犯的是同一种错,只是 unconditional 那边更重。既然两边都有,在 r 这个比值里就抵消了,那些区域的 r ≈ 1,于是被 r^(γ−1) 压低。
这个说法给出一个可以证伪的推论:只有两个分支共有的误差会被消除,conditional 分支独有的误差会被放大。这一点和「CFG 去掉 outlier」的说法不同——按后者,误差来自哪一个分支并不重要。
三个效应,换个角度重读
| 效应 | 分布角度 | 误差角度 |
|---|---|---|
| 效应一 | 按 r 重新分配 mode | 压低因密度铺开而多出来的、本不该存在的 mode |
| 效应二 | 朝两个分支更一致的方向移动 | 离开 unconditional 分支误差主导的区域 |
| 效应三 | mode 变窄 | 去掉密度铺得过开带来的额外方差 |
这和把 Δ 分解为多个分量来分析的那一类工作是一致的——Li 等人[5]分解出的一项正是「压制 unconditional 数据里普遍存在的通用特征」。同一件事的两种说法。
最优的 γ 在哪
γ 太小,误差没抵消完;γ 太大,tilt 带来的偏差超过了被抵消的误差。最优的 γ 就是两者平衡的地方——这就是质量指标对 γ 呈 U 形的原因。
还有一部分和分布无关
还有一部分「变好」和分布没关系。人偏好高对比、饱和、构图干净的图像,而高 γ 恰好给的就是这些。分布指标衡量不到这一部分,人类评测能,而审美偏好和「更接近真实数据」是两回事,有时甚至相反。
所以「看起来变好」至少是三件事叠在一起:误差被抵消(真的变好)、tilt 带来的偏差(真的变差)、审美偏好(评价标准本身的问题)。把这三件事拆开,是这篇文章想做的事。
06这对训练模型意味着什么
如果 CFG 本质上是在修模型的误差,有几条可以直接使用的推论。
CFG 的必要强度,反映的是模型的误差
极限情况是一个完全准确的模型不需要 CFG,所以模型越准,需要的 γ 越小。反过来也可以利用这一点:Karras 等人[4]用同一个模型刻意训练不足的版本代替 unconditional 分支,让 r 更纯粹地指向误差的方向,ImageNet 上达到 FID 1.01。两条路线的前提相同——CFG 的作用对象是误差,不是条件。
调 γ 时会遇到两个不同的临界点
增大 γ 会先后遇到两件事:到某个值时效果最好;继续增大,输出开始出现明显缺陷——图像上是过饱和,几何上是结构崩坏。这是两个不同的临界点,由不同的因素决定。
| 决定因素 | 模型变好时 | |
|---|---|---|
| 效果最好的那个 γ | conditional 和 unconditional 两个分支误差的差距 | 下降 |
| 开始出现缺陷的那个 γ | 模型本身的精度——γ 越大越是在外推 | 上升 |
所以随着训练推进,两者之间可用的范围会变宽。我们没有见到文献报告过这种分离,而在任何一组 checkpoint 上都可以测。跟踪最优 γ 的变化,还能看出 conditional 分支相比 unconditional 分支改进了多少——γ 就不只是推理时调的参数了。
调度怎么设计
| 区间 | 在这里施加 CFG 会得到什么 |
|---|---|
| 高噪声 | 样本落在哪个 mode、中心往哪个方向移动,全部在这一段决定。去掉这一段等于放弃对结果的控制 |
| 低噪声 | 只剩效应三在起作用。去掉这一段,收窄就没有了 |
所以「只在某一段噪声上施加 CFG」这类调度,在不同的模型上得到的结果可能完全不同——取决于该模型的 mode 在哪一段噪声上被决定。这个位置可以测(把 CFG 分段施加,比较 mode 占比),建议先测再定调度。
实验是怎么做的
范围:上面所有实测都在一个模型上完成——一个图像/文本条件的 3D rectified-flow 模型,64³ 的占据场。这些结果能说明的是这个模型上发生了什么,不能替其他模型作保。
| 模型 | 图像/文本条件的 3D rectified-flow,45 步,输出 64³ 连续占据场 |
| 规模 | 约 13000 个样本,8×B200 上约 5 GPU-小时 |
| γ 网格 | 1, 1.25, 1.5, 2, 3, 5, 6, 9, 15, 25。每点 128 个种子 |
| 配对 | 开 CFG 与不开 CFG 两组共用种子和初始噪声,所以逐样本的比较成立 |
| 方差 | 样本两两平方距离的均值除以 2(协方差的迹),400 次自助法给标准误 |
| mode 判别 | 占据场池化到 16³ 并除以总质量,用手选 exemplar 建的一条轴;留一验证 93.3% |
| 渲染 | DDA 逐面平直着色,法线取射线穿过的立方体面。不是光滑等值面——数据是体素 |
几个必须注意的实现细节:γ=1 走的是另一条代码路径(管线按 cfg>1 分支);「unconditional」分支默认带着出厂的负提示词,不是空串;latent 的欧氏度量几乎分不出条件(九个条件之间总方差只差 12%),所以聚类都在几何特征上做;噪声分段不能按步数索引定义,必须读 denoiser 实际收到的 t′;采样器本身是混沌的,任意微扰在 45 步里都会发散到 0.08–0.11σ,所以 t′<0.6 那一行只有底噪的 1.7 倍,t′<0.8 才是明确的。
参考文献
- Jonathan Ho, Tim Salimans. Classifier-Free Diffusion Guidance. NeurIPS 2021 Workshop on Deep Generative Models. arXiv:2207.12598
- Yuchen Wu, Minshuo Chen, Zihao Li, Mengdi Wang, Yuting Wei. Theoretical Insights for Diffusion Guidance: A Case Study for Gaussian Mixture Models. ICML 2024. arXiv:2403.01639
- Gen Li, Yuchen Jiao. Provable Efficiency of Guidance in Diffusion Models for General Data Distribution. 2025. arXiv:2505.01382
- Tero Karras, Miika Aittala, Tuomas Kynkäänniemi, Jaakko Lehtinen, Timo Aila, Samuli Laine. Guiding a Diffusion Model with a Bad Version of Itself. NeurIPS 2024. arXiv:2406.02507
- Xiang Li, Rongrong Wang, Qing Qu. Towards Understanding the Mechanisms of Classifier-Free Guidance. 2025. arXiv:2505.19210